클로드·GPT·제미나이에게 같은 브라우저를 만들게 했어요
라이브
첫 섹션은 누구나 읽을 수 있어요. 나머지 섹션의 전문·프롬프트 원문·Q&A는 라이브 프리미엄 멤버십 회원 전용이에요.
2026-11-19 라이브 · 2시간 33분 · 다시보기
최근 클로드·GPT·제미나이가 모두 새 모델을 냈어요. 벤치마크 점수 대신 같은 일을 시켰어요. AI 브라우저 Aside를 역공학으로 뜯어 요구사항을 뽑고, Rust로 다시 만드는 일이에요.
방송 두 시간 전에 같은 지시문으로 동시에 출발시켰고, 방송에서는 결과물을 직접 써 본 뒤 한 번 더 고치게 했어요. 첫 결과와 마지막 결과의 1등이 달랐어요.
이 노트를 읽고 나면 할 수 있는 것
- 모델 비교 실험을 직접 설계하기: 같은 지시문, 같은 출발 시각, 마감, 그리고 미리 정한 채점 축
- 에이전트가 만든 앱을 "테스트 통과"가 아니라 실제로 써 보면서 핵심 기능(이어서 일하기·내용 읽기·완수)으로 검수하기
- 모델별 작업 성향을 보고 역할을 나누기: 검증은 누구에게, 화면은 누구에게
목차
- 벤치마크 말고, 같은 일을 시켜 봤어요 ▶ 0:10:35
- 과제: Aside를 뜯어서 Rust로 다시 만들기 ▶ 0:15:49
- 1차 결과 ①: 페이블과 아스트라의 브라우저 ▶ 0:18:34
- 1차 결과 ②: 카본은 가장 빨랐고 가장 예뻤지만 ▶ 0:37:34
- 1차 채점: 끝까지 해낸 건 페이블 하나 ▶ 0:44:46
- 2라운드: 한 번 더 시키자 순위가 흔들렸어요 ▶ 0:47:47
- 제미나이 니온이 만든 에이전트 화면 ▶ 1:36:18
- 결론: 첫 프롬프트 한 번으로 모델을 고르지 마세요 ▶ 1:48:29
- Q&A ▶ 1:55:37
- 오늘 해볼 것 ▶ 1:49:37
벤치마크 말고, 같은 일을 시켜 봤어요 ▶ 0:10:35
저는 평소에 클로드 오퍼스(Opus)만 써요. 그것만으로 일이 충분히 되거든요 ▶ 0:10:40. 그런데 최근 클로드는 페이블(Fable) 5.2, 제미나이는 카본(Carbon), GPT는 아스트라(Astra)를 냈고, 특히 제미나이가 괜찮다는 이야기가 많았어요 ▶ 0:12:30.
모델을 비교할 때 흔히 벤치마크 점수를 보거나 게임 하나를 만들게 해요. 그런 것보다 실전성이 높은 일을 한번 맡겨 보고 싶었어요. ▶ 0:13:05 그래서 세 회사 구독을 모두 비싼 요금제로 결제했어요 ▶ 0:13:18.
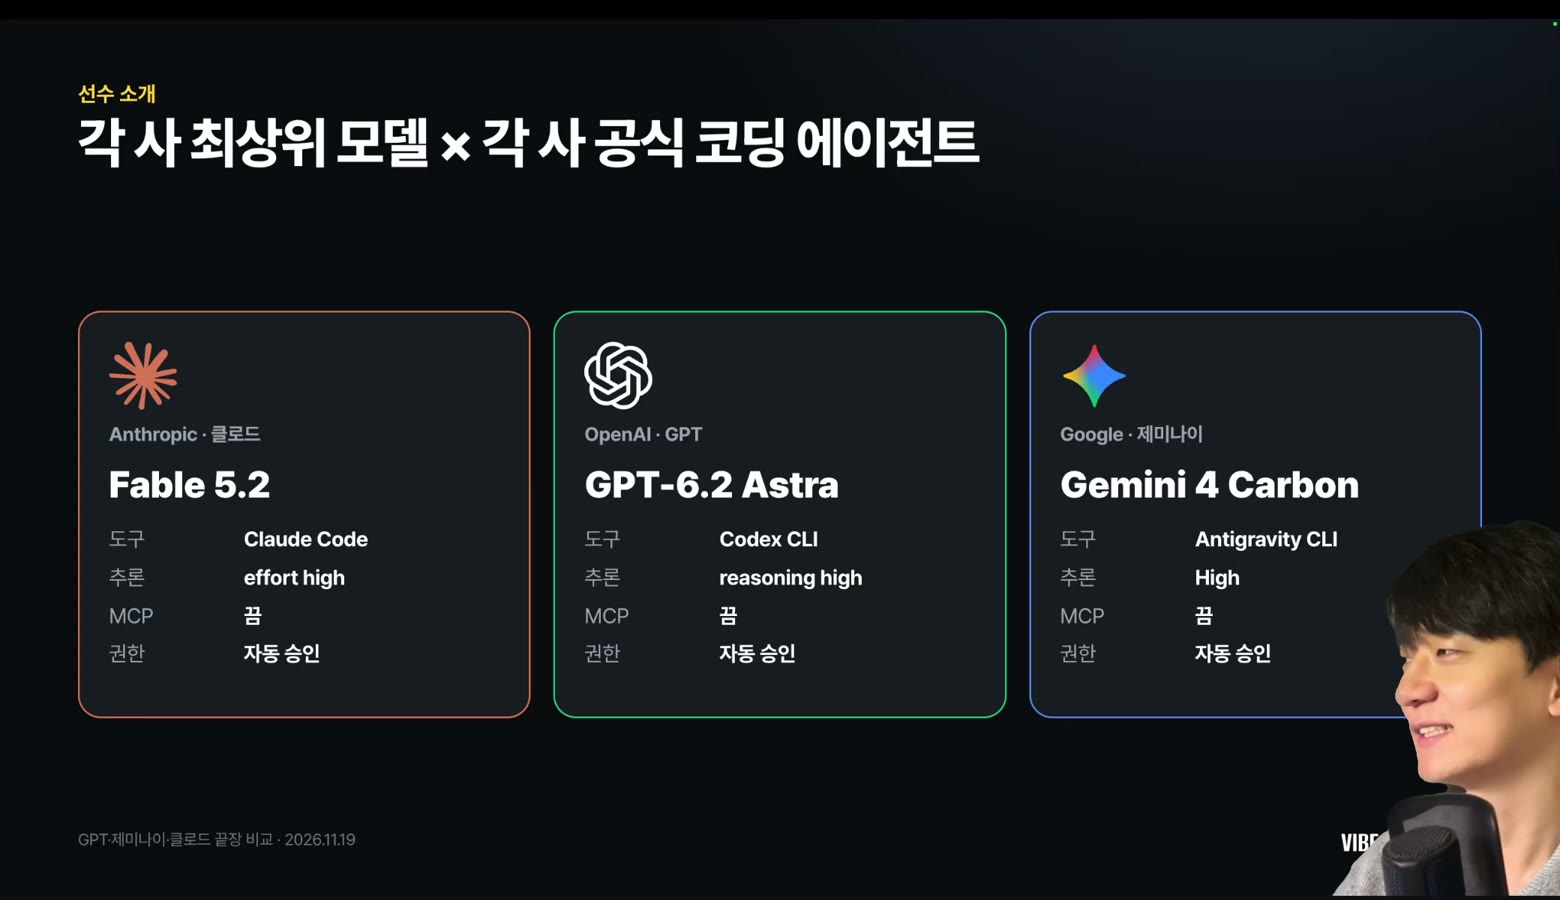
선수는 각 회사의 최상위 모델을 그 회사의 공식 코딩 에이전트로 돌린 조합이에요.
- 클로드: Fable 5.2 + Claude Code, 추론 수준(effort) high
- GPT: GPT-6.2 Astra + Codex, 추론 수준(reasoning) high
- 제미나이: Gemini 4 Carbon + Antigravity CLI, 추론 수준 High. 요즘 구글은 Gemini CLI보다 Antigravity CLI를 미는 것 같아요 ▶ 0:15:38
추론 수준을 최대(max)로 두지 않은 데는 이유가 있어요. max는 비싸기도 하지만 너무 느려요. 실제로 개발할 때는 피드백을 주고받는 티키타카가 필요하니, 현실적으로 쓰는 high로 맞췄어요 ▶ 0:14:30. MCP와 개인 도구는 모두 껐고 권한은 자동 승인으로 열어 뒀어요 ▶ 0:14:52.